quarta-feira, 22 de junho de 2016

Perguntas frequentes em bioestatística #15. E quando as regras da estatística não se parecem aplicar?


A seguinte mensagem é a décima quinta comunicação da série Perguntas Frequentes em Bioestatística, da autoria de membros do Laboratório de Bioestatística e Informática Médica da Faculdade de Medicina da Universidade de Coimbra. Pretende-se fomentar uma discussão sobre as melhores práticas estatísticas na área da saúde.

Miguel Patrício, Francisco Caramelo

A Estatística é um mundo complexo de regras e excepções, com diferentes estratégias para lidar com o mesmo problema e muitos avisos sobre o que é pouco aconselhável fazer-se. É frequentemente difícil desbravar o caminho no meio dos dados colhidos e conseguir extrair conclusões dos mesmos. Em simultâneo, é comum a noção (errada) que torturando os dados se pode sempre descobrir algum padrão ou extrair alguma informação apelativa. Esta forma de pensar é, mais do que se gostaria de admitir, profícua no mundo da investigação - de facto, após a recolha dos dados existe a ideia que é quase sempre possível efectuar diferentes análises estatísticas, obter algum valor-p interessante do ponto de vista da publicação (tipicamente, p<0.05) e construir uma narrativa. Inverte-se assim a lógica do método científico, em que o ponto de partida é uma questão, se recolhem dados para responder a esta e os mesmos são analisados para se obter a resposta. Deste modo, a colocação a posteriori de perguntas, após a recolha dos dados, constitui uma forma errada de construir Ciência e é fonte de inúmeros erros. É aliás um dos factores que contribui para erodir a credibilidade das publicações científicas[1]. 

Tem havido uma grande discussão sobre a credibilidade da ciência, das revistas e do sistema de peer-review. São sobejamente conhecidos exemplos de autores que conseguem publicar, em revistas de reputação pouco sólida, artigos com conteúdo jocoso[2]. O problema de se publicar o impublicável afecta também melhores revistas, em que os editores e revisores muitas vezes não estão avisados para erros básicos como o que se referiu em cima, de colocação de uma pergunta a posteriori[3] ou para outros de carácter estatístico ou metodológico. De facto, com boa ou má intenção, muitas publicações têm erros crassos que podem ser evitados tendo-se em conta princípios básicos da Estatística (ou, com igual propriedade, do Método Científico e do bom senso) como:

  • As perguntas têm de ser colocadas a priori, antes da recolha dos dados. A análise estatística deve ser feita tendo as perguntas previamente colocadas em mente[4];
  • A inferência estatística (por outras palavras, o cálculo de valores-p[5]) deve ser feita apenas quando fizer sentido. Deve-se ser parcimonioso, pois o recurso a muitos testes estatísticos obriga a correcções de comparações múltiplas[6];
  • O tamanho da amostra deve ser suficientemente grande se se pretende fazer inferência. A razão é simples: para se poder inferir algo é preciso ter confiança nessa inferência - é preciso ser convincente. Dificilmente se consegue ser convincente com tamanhos amostrais como n=3. Há fórmulas para calcular o tamanho amostral[7];
  • O tamanho do efeito deve ser objecto de discussão independentemente do significado estatístico[8].

Há muitas outras regras, ditadas pela Estatística, pelo Método Científico ou pelo bom senso, que se poderiam acrescentar à lista em cima. Como sempre acontece quando há muitos cuidados a ter em conta nalguma tarefa, torna-se difícil, mesmo para a pessoa mais bem intencionada, tomar outra posição que não seja ficar bloqueado ou avançar de forma temerária. Em paralelo, para quem ensina Estatística[9], colocam-se também desafios complicados - reduzir a complexidade de uma disciplina a algumas horas implica fazer escolhas como apresentar sempre exemplos simples, desenhos de estudo claros, questões em que a resposta seja linear. A realidade, porém, é muito mais rica, complicada e não linear. Nalguns casos, aparenta chocar com as regras da Estatística. Por exemplo, é frequente que quem trabalha com animais se queixe de não poder ter um tamanho amostral grande. E, se relativamente a isso a Estatística é clara (para se fazer inferência é preciso calcular o tamanho amostral a priori), a prática vai noutra direcção - raramente se deixa de fazer um trabalho por considerações sobre o tamanho amostral. É também comum apresentarem-se valores-p em situações que não faz sentido. Se nalgumas revistas já começa a ser colocado em causa o foco excessivo no valor-p[10], este ainda é necessário para conseguir publicações com impacto na maioria das áreas.
A aparente ou real falta de consenso e harmonia entre as exigências da Estatística (e do bom senso) e as exigências do sucesso académico levam a que facilmente as primeiras sejam abandonadas ou deturpadas. A persistência em erros comuns é ainda banal, embora vá havendo cada vez maior discussão e esforço para depurar a Ciência. Em particular, vê-se com assustadora frequência:

  • a indefinição da questão de investigação;
  • o recurso a um número excessivo de testes estatísticos num mesmo trabalho, sem recurso a correcção para comparações múltiplas;
  • a interpretação abusiva do valor-p;
  • o recurso a testes paramétricos quando deveriam ser não paramétricos;
  • más representações gráficas dos resultados[11], que induzem a interpretações erradas

 Urge procurar caminhos que compatibilizem o rigor da Estatística e do Método Científico com as práticas académicas. Se o rigor é inegociável, ou se alteram as práticas na sua substância ou estas terão de ser reinterpretadas, de forma a que explicitamente se afirme os limites da sua validade. Nesse sentido, há algumas ideias que poderão ser úteis:

  • Qualquer trabalho de índole estatístico deverá ter duas fases: uma fase de planeamento e uma fase de concretização. Na primeira fase, terá de definir-se claramente qual é a questão de investigação a que se pretende responder. Tudo o resto ficará subordinado a esta questão. Desta forma, a análise dos dados obtidos é determinada claramente pela questão de investigação, que não faz sentido definir a posteriori;
  • É importante distinguir trabalhos exploratórios ou descritivos de trabalhos confirmatórios. Nos últimos pretende-se responder a uma questão muito específica, sendo o foco colocado na inferência. Nos primeiros pretende-se fazer um trabalho meramente descritivo (sem desprimor para a sua importância) ou procurar questões que possam ser posteriormente reanalisadas num trabalho confirmatório. Em trabalhos confirmatórios é fundamental fazer o cálculo do tamanho da amostra. Não sendo isto feito, o trabalho é automaticamente exploratório ou descritivo, não fazendo sentido calcular valores-p no seu sentido usual[12];
  • O valor-p, como interpretado no sentido usual, apenas deverá ser calculado quando se pretenda fazer inferência estatística. Para esse efeito, deverá ter-se tido em conta cálculos do tamanho amostral. Mais ainda, o valor-p não deverá ser apresentado sem que, em conjunto, se apresentem medidas descritivas. De facto, é importante distinguir entre significância estatística e significância biológica (ou clínica) - o valor-p apenas se refere à primeira[13];
  • Nalguns casos é possível calcular o valor-p sem se ter calculado primeiro o tamanho da amostra. Assim, mesmo em estudos exploratórios ou descritivos é aceitável a apresentação de valores-p. Porém, o significado dos mesmos devem ser clarificados: não se pretendendo fazer inferência, o valor-p serve como uma medida de tamanho do efeito, sendo meramente descritivo. Neste sentido, ter-se p<α não tem o significado usual de se ter significância estatística[14], ou seja, de se poder concluir algo relativamente à população. A interpretação deverá ser diferente: quanto mais pequeno for o valor-p, maior será o tamanho do efeito que se observa.
  • É possível fazer muitos testes estatísticos num mesmo trabalho, mas terá de se recorrer a correcções para comparações múltiplas ou interpretar os valores-p obtidos no sentido exposto no último ponto - como sendo uma medida do tamanho do efeito.
Na verdade, as regras da Estatística, do Método Científico e do bom senso deverão aplicar-se sempre. Compatibilizar as mesmas com as práticas exigidas para se obter sucesso académico pode ser difícil, mas ou é possível ou o sucesso será imerecido. Uma transferência de saber transparente clarificando os aspectos anteriormente discutidos também ajuda o leitor a julgar de forma crítica os achados em cada trabalho.


[1] A este respeito, vale a pena ler o artigo: Ioannidis JPA (2005) Why Most Published Research Findings Are False. PLoS Med 2(8): e124. doi: 10.1371/journal.pmed.0020124 ou o artigo “Estimating the reproducibility of psychological science”: Open Science Collaboration, Science 349, aac4716 (2015). DOI: 10.1126/science.aac4716.
[2] Ver, por exemplo, o seguinte artigo publicado por personagens dos Simpsons http://www.sciencealert.com/two-scientific-journals-have-accepted-a-study-by-maggie-simpson-and-edna-krabappel ou um artigo com linguagem imprópria em http://www.vox.com/2014/11/21/7259207/scientific-paper-scam.
[3] Um exemplo famoso da colocação de uma pergunta a posteriori (que estatisticamente se traduz pela necessidade de efectuar uma correcção para comparações múltiplas) é explicado pelo autor de um artigo que proclamava mostrar que comer chocolate preto ajuda a emagrecer. Na verdade, a colocação da questão de investigação a posteriori foi propositado e teve como objectivo demonstrar que este é um erro comum, como explica o próprio autor do artigo aqui: http://io9.gizmodo.com/i-fooled-millions-into-thinking-chocolate-helps-weight-1707251800.
[5] O cálculo de um valor-p é efectuado tendo em conta a amostra e a população. Por outras palavras, quando se aplica um teste estatístico a dados amostrais, calcula-se um valor-p. Quando este é inferior ao nível de significância (tipicamente α=0.05) rejeita-se a hipótese nula para toda população. Por exemplo, se ao comparar níveis médios de colesterol entre amostras de dois grupos, se obtiver p<α, então pode-se inferir que há diferenças entre as médias populacionais dos níveis de colesterol dos dois grupos. A partir das amostras dos grupos infere-se o que acontece na população.
[8] Ver Sullivan, G. M., & Feinn, R. (2012). Using Effect Size—or Why the P Value Is Not Enough. Journal of Graduate Medical Education, 4(3), 279–282. http://doi.org/10.4300/JGME-D-12-00156.1.
[9] São comuns as queixas do ensino da Estatística ser muito desfasado da realidade com que o investigador se depara. Descontadas as naturais faltas de perfeição dos professores da disciplina, até certo ponto tal desfasamento deve-se à realidade exigir um grau de complexidade que transvasa aquilo que se pode ensinar em poucas horas. Porém, também tem a ver com um desrespeito generalizado que se verifica, no mundo da Ciência, pelo Método Científico. Se cabe ou não à Estatística - ou apenas à Estatística - procurar resolver este último aspecto é discutível.
[10] Não se coloca aqui em causa a importância do valor-p, mas sim que o mesmo seja excessivamente calculado e valorizado: ver http://laboratoriobioestatistica.blogspot.pt/2015/05/p-value-o-grande-enganador-ou-como.html. Vale também a pena ler o artigo seminal Johnson, D. (1999). The Insignificance of Statistical Significance Testing. The Journal of Wildlife Management, 63(3), 763-772. doi:1. Retrieved from http://www.jstor.org/stable/3802789 doi:1.
[11] Por exemplo, apesar da sua quase omnipresença, o uso de gráficos de barras para representar variáveis quantitativas deve ser desencorajado, ver por exemplo Streit M, Gehlenborg N. Bar charts and box plots. Nat Methods 2014; 11:117.
[12] Por sentido usual, pretendemos dizer no sentido inferencial. Por outras palavras, a menos que o estudo seja confirmatório, o objectivo não deverá ser verificar se uma determinada hipótese, colocada relativamente a uma população, pode ou não ser rejeitada.
[14] Não se pode, desta forma, afirmar haver diferenças estatisticamente significativas. É possível explicitar qual foi o valor-p obtido, mas tendo em conta que este é uma medida do tamanho do efeito e não uma indicação de podermos ou não inferir algo acerca da população.

quinta-feira, 19 de maio de 2016

Perguntas frequentes em bioestatística #14. Com a estatística também se erra?


A seguinte mensagem é a décima quarta comunicação da série Perguntas Frequentes em Bioestatística, da autoria de membros do Laboratório de Bioestatística e Informática Médica da Faculdade de Medicina da Universidade de Coimbra. Pretende-se fomentar uma discussão sobre as melhores práticas estatísticas na área da saúde.

Bárbara Oliveiros, Francisco Caramelo e Miguel Patrício

Em análise estatística existem vários tipos de erros, tanto na fase de desenho do estudo quanto na fase de aplicação do protocolo experimental. Os erros podem ocorrer na colheita dos dados, no seu registo, na sua análise ou mesmo ao relatar resultados e extrair conclusões. Por outro lado, também os próprios métodos estatísticos assentam na medição da incerteza, com bases fortes na teoria de probabilidades. Deste modo, em Estatística, não existem resultados exactos, mas apenas resultados prováveis. Sendo-se mais preciso e adoptando a perspectiva das teorias frequencistas que remontam ao início do século XX (tendo como “pai” Sir Ronald Fisher e sendo estas as mais utilizadas actualmente), os resultados em estatística são prováveis com um determinado grau de confiança, ou com um erro inferior a um limite pré-estabelecido. Citando Samuel Langhorne Clemens, mais conhecido por Mark Twain, “há mentiras, mentiras malditas e estatísticas”. Isto não significa que todas as estatísticas sejam mentira, mas também não significa que todas as estatísticas sejam 100% verdade. Existe sempre algum erro associado a qualquer inferência estatística que se faça de uma amostra para a população.

É útil distinguir duas fases numa análise estatística: “Estatística Descritiva” e “Estatística Inferencial”. No que diz respeito à estatística descritiva, esta pode ser realizada relativamente a uma amostra ou para toda a população, pelo que não existe erro associado às medidas obtidas para além do próprio erro inerente às medições e instrumentos de medida usados. A partir do momento em que fazemos inferência acerca dos valores observados na amostra (procurando extrair informação para a população), então temos ainda de somar aos erros das medições e instrumentos de medida o erro associado à amostragem, uma vez que estamos a tirar conclusões para um conjunto de sujeitos para os quais não efectuámos medições directas.

O processo de inferência estatística divide-se geralmente ainda em “Teoria da Estimação”, onde são vulgarmente utilizados intervalos de confiança para um dado parâmetro, e “Teoria da Decisão” onde se aplica um ou mais testes estatísticos. Terá de se ter em atenção que o conjunto de testes estatísticos a aplicar deverá ser o indicado para responder à questão de investigação colocada e também deverá estar de acordo com o nível de mensuração das variáveis e com o papel das mesmas. A não observância destes cuidados leva certamente à introdução de um factor de erro adicional na análise. Naturalmente, esta não é a única premissa que preside à escolha dos testes: em cada estudo, o conjunto de testes a aplicar deverá ter em conta o princípio segundo o qual se deve recorrer à aplicação do teste mais potente para cada situação, como explicitado de seguida.

Um teste estatístico tem por base duas hipóteses, denominadas por hipótese nula (H0), que é considerada verdadeira até prova em contrário, e hipótese alternativa (H1 ou HA). A sua aplicação visa determinar se existe evidência suficiente para se abandonar a hipótese nula e tomar como verdadeira a alternativa. A formulação da hipótese nula, que como o nome indica representa uma “nulidade”, é baseada numa ausência de efeito que se pode traduzir, por exemplo, na ausência de diferença ou na ausência de associação. Obviamente que na população nunca podemos determinar se a hipótese nula é realmente válida ou não, a não ser realizando um censo. No entanto, a partir dos dados amostrais podemos tentar avaliar a plausibilidade da hipótese nula: partindo do pressuposto de que a mesma é verdadeira, mede-se a probabilidade de se encontrar dados amostrais como os observados ou mais afastados do que seria expectável. A esta probabilidade dá-se o nome de valor-p, ou probabilidade de significância. Na prática, quando se encontra um valor-p pequeno, rejeita-se a hipótese nula e toma-se como verdadeira a hipótese alternativa. Naturalmente, nem sempre tal é correcto: poderá por mero acaso encontrar-se uma amostra distante do que seria de esperar, à qual corresponderá um valor-p pequeno, e ainda a hipótese nula ser verdadeira. É improvável, mas possível. Quando tal acontece e se rejeita a hipótese nula, comete-se um erro tipo I. O limite superior que estamos dispostos a aceitar para este erro é normalmente representado por a e denomina-se nível de significância do teste estatístico: tal leva a que se rejeita a hipótese nula quando p<α. O nível de significância (α) do teste deve ser definido a priori no desenho do estudo, de forma a não dar azo à escolha conveniente de um nível de significância que permita rejeitar a hipótese nula após análise dos dados - este procedimento, além de introduzir um viés no estudo, também invalida o desenho do mesmo. Normalmente, é usado o valor α = 0,05. Assim, sempre que se obtenha um valor-p inferior a 5% poderemos afirmar que existe evidência estatística suficiente para rejeitar a hipótese nula. Dado que a hipótese nula indica ausência de efeito, a rejeição da mesma significa em linguagem comum que o efeito observado nos dados amostrais pode ser estendido para a população. Interessa enfatizar que esta afirmação de inferência para a população tem evidentemente associado um erro potencial igual ao valor-p obtido.

Como vimos, o valor de  adoptado num estudo limita a probabilidade máxima de se cometer erros tipo I. Note-se que a escolha do nível de significância (α) depende do estudo em causa. Em determinados estudos, como por exemplo nos ensaios de bioequivalência de fármacos para introdução de fármacos novos no mercado, é importante considerar pequenos efeitos como estatisticamente significativos. Desta forma, o nível de significância a considerar é maior que os habituais 5%: usualmente é de 10%. Ao invés, quando se pretende reduzir a ocorrência de falsos positivos face ao aumento de falsos negativos, ou seja, se pretendermos tornar o teste estatístico mais específico à custa da perda na sensibilidade, então é preferível usar α = 0,01. Contudo, qualquer que seja o nível de significância a adoptar, este deve ser definido a priori e ser constante ao longo de todo o estudo.

Os erros tipo I também podem ocorrer no cálculo de estimativas intervalares para parâmetros. De facto, a estatística reproduz a incerteza nos resultados recorrendo a intervalos de confiança. Como o nome indica, o intervalo de confiança é um intervalo de valores dentro do qual se estima que o parâmetro em consideração (e.g. média, proporção, variância) se encontre com uma confiança de (1-α)x100% . Por exemplo, o intervalo de confiança para a média a 95% (IC95%) indica o intervalo de valores dentro do qual se pressupõe estar a média da população com uma probabilidade de 95%. Percebe-se, então, que a apresentação do intervalo de confiança admite uma possibilidade de erro (exprime incerteza) que no caso do IC95% seria de 5%.

Portanto, quando vemos publicitado que um determinado candidato tem entre 40 a 45% das intenções de voto, com 95% de confiança, sabemos que com base nas intenções de voto obtidas por uma sondagem (amostra, supostamente aleatória e representativa da população), o valor esperado para a proporção de votos de toda a população estaria entre os 40 e os 45%, sendo o erro associado de 5%. Quando um anúncio afirma “perca até 10 kg em 2 meses”, é razoável subentender-se que se tivermos obtido 100 amostras diferentes de pessoas que experimentaram a dieta em causa, em cerca de 95 amostras a redução média de peso em 2 meses tinha sido um valor até 10 kg. Contudo, é importante notar que a redução anunciada de 10 kg é uma média pelo que nalguns casos a redução foi menor ou poderá até ter havido aumento de peso. Ora, conhecer o limite inferior do intervalo de confiança torna-se fundamental já que se este for negativo, significa que pode haver lugar ao aumento do peso médio. Em termos de teste de hipóteses a ausência de efeito da dieta (H0) traduz-se por uma redução nula. Se o intervalo de confiança para a redução de peso fosse tal que o limite inferior é negativo e o superior é positivo isto indicaria que a redução nula (valor zero de redução) se encontra dentro do intervalo. Por conseguinte, teríamos de admitir que nesse caso não existiria um efeito estatisticamente significativo (logo, que não existiria evidência para rejeitar a hipótese nula).

Centrámo-nos até ao momento no erro tipo I que ocorre quando se rejeita a hipótese nula mas a mesma é realmente verdadeira. Contudo, outro erro pode ocorrer não rejeitar a hipótese nula e ela ser realmente falsa. Designa-se este erro por erro tipo II e a sua probabilidade de ocorrência é normalmente representada por β. Na prática, em vez de nos centrarmos no valor de β, é mais usual pensar na probabilidade da rejeição da hipótese nula sendo ela realmente falsa, ou seja, em (1 - β). Esta quantidade designa-se por potência do teste, sendo desejável que seja o mais alta possível (apontando-se o valor de 80% como potência mínima desejável).

Ao realizar um teste de hipóteses, qualquer que seja a decisão que tomemos acerca da rejeição ou não da hipótese nula, e dado que nunca conhecemos a sua veracidade a não ser que possamos medir toda a população (e nessa situação o teste estatístico é desnecessário), teremos sempre presente a probabilidade de cometer erros tipo I e tipo II. Estes erros estão dependentes da dimensão do efeito observado (effect size[1]), que por sua vez depende da dimensão da amostra e da sua variabilidade.
Na figura 1 podemos observar um exemplo da variação da potência do teste t-Student, bicaudal, em função da dimensão da amostra. O gráfico foi obtido tendo como fixos o effect size (d = 0,225) e o nível de significância (a = 0,05) e recorrendo ao software GPower. Podemos observar que para detectar o tamanho do efeito considerado com uma potência mínima dentro do que é considerado como razoável (80%), seria necessário ter uma amostra de dimensão n = 160.


Figura 1 – Variação da potência do teste t-Student para uma amostra (bilateral) de acordo com a variação da dimensão da amostra

O nível de significância (α) , a potência do teste (1-β), o tamanho do efeito e o tamanho da amostra estão interligados e, por isso, qualquer alteração num deles provoca alterações nos restantes. As relações existentes entre estes factores permitem então realizar dois tipos de cálculos diferentes: tamanho da amostra e potência de um estudo. O cálculo do tamanho da amostra realiza-se fixando o nível de significância (α), a potência do teste (1-β) e o tamanho do efeito (o qual é estimado recorrendo a estudos piloto, a publicações existentes ou a considerações sobre significância clínica). Já a potência do estudo é feita fixando o nível de significância (α), usando o tamanho da amostra que se usou e o tamanho do efeito que foi observado no estudo realizado. Como se pode depreender, o cálculo do tamanho da amostra é uma análise que é feita antes do estudo ser realizado e o cálculo da potência é feito depois do estudo ter sido concluído.

Na figura 2, obtida na aplicação GPower, podemos observar as variações (o aumento) da potência do teste Z (bicaudal) devido às variações (aumento) do effect size. Quanto maior o efeito, mais provável é obtermos diferenças estatisticamente significativas, e também mais provável é estas diferenças serem, de facto, verdadeiras.


Figura 2 – Variação da potência do teste Z (bicaudal) de acordo com a variação na dimensão do efito (effect size)

Não podemos contudo deixar de frisar que a ausência de diferenças estatisticamente significativas não significa que não existam diferenças clinicamente significativas, pelo todos estes aspectos devem ser ponderados.


Na próxima edição do Perguntas Frequentes em Bioestatística: “E quando as regras da estatística não se parecem aplicar?”


[1] O effect size é uma quantidade que exprime as diferenças que esperamos encontrar entre dois grupos. Por exemplo, se o grupo A tiver média 10 e desvio padrão 2 e o grupo B tiver média 5 e desvio padrão também 2, o effect size será (10-5)/2=2.5. Quanto maior o effect size, maiores serão as diferenças entre os grupos (tendo em conta a variância em cada grupo).

sexta-feira, 13 de maio de 2016

Cursos LBIM 2016


Para inscrições ou mais informações, poderá consultar o site.

quarta-feira, 11 de maio de 2016

A ciência, vista por John Oliver

Uma das maiores preocupações do Laboratório de Bioestatística e Informática Médica é a qualidade da investigação nas Ciências da Saúde. Cada vez mais, no ensino e na prática diária, colocamos maior ênfase em metodologias (e no método científico) que em fórmulas. Os cursos LBIM 2016 são prova disso mesmo: os dois primeiros cursos foram dedicados ao desenho de estudo e a como pensar problemas do ponto de vista estatístico. Tudo o mais, é instrumental. Em Setembro, oferecemos um curso de uma tarde dedicado à Investigação Replicável. Queremos discutir o que está mal na Ciência e como evitar os erros mais comuns. Naturalmente, a preocupação não é só nossa. Vale a pena ver o vídeo:


Final da época desportiva vista do ponto de vista estatístico

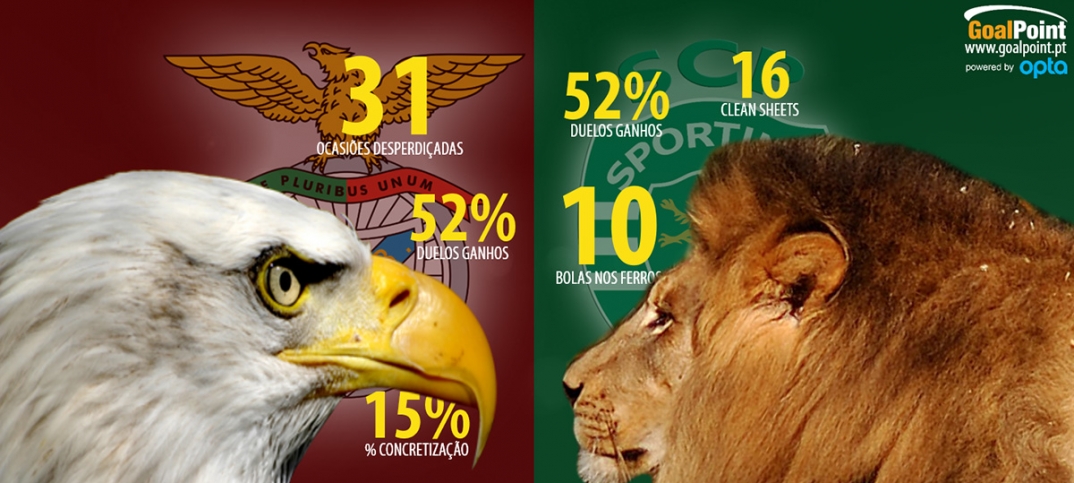
Agora que a época desportiva futebolística se aproxima do final, acende-se a discussão de qual foi a melhor equipa este ano: Benfica ou Sporting. Opiniões subjectivas há para todos os gostos, quem preferir dados mais objectivos pode consultar este site.


segunda-feira, 4 de abril de 2016

LBIM no Porto

Tivemos a felicidade de ser convidados para dar uma aula de Estatística na Escola Superior de Tecnologia da Saúde do Instituto Politécnico do Porto, sendo esta dividida em três partes:

- Importância de uma boa definição da questão de investigação;
- Técnicas estatísticas: quais existem e como escolher entre elas;
- Roteiro para o desenho de um estudo clínico;
 
 Foram 4 horas intensas, com muita participação por parte da audiência e com direito até a bolo de aniversário (pão de ló com recheio e cobertura de chocolate). Seguem as fotos.


Correlações

"Correlation does not imply causation" é das frases de inspiração estatística mais repetidas. E, de facto, não faltam exemplos (alguns até bastante cómicos) de correlações espúrias. Ainda assim, a análise da correlação entre variáveis é uma ferramenta muito importante em Ciência. E agora, para os mais nerds, é também um jogo. Quem quiser adivinhar o grau de correlação entre duas variáveis quantitativas, poderá fazê-lo aqui.